Показаны сообщения с ярлыком hash. Показать все сообщения

четверг, 21 марта 2024 г.

Популярные группы leetcode задач

Популярные группы leetcode задач с кратким описание и полным кодом.
Алгоритмы написаны на Scala 2.12 в java стиле.
Задача может быть сразу в нескольких разделах.

понедельник, 18 февраля 2019 г.

RBTree - красно-черное дерево

Красно-чёрное дерево (Red-black tree, RB-Tree) — самобалансирующееся двоичное дерево поиска, гарантирующих логарифмический рост высоты от числа узлов.

Дополнительные требования к двоичному дереву:
1. Узел либо красный, либо чёрный
2. Корень — чёрный
3. Все листья (NIL) — чёрные (листья не содержат данных)
4. Оба потомка каждого красного узла — чёрные.
5. Всякий простой путь от данного узла до любого листового узла, являющегося его потомком, содержит одинаковое число чёрных узлов.
Эти ограничения реализуют главное свойство красно-чёрных деревьев: путь от корня до самого дальнего листа не более чем в два раза длиннее пути от корня до ближайшего листа.
Результатом является то, что дерево примерно сбалансировано.

Реализацию красно-черного дерева на java можно посмотреть тут: RBTree.java

Но в такой реализации оно сложно для понимания и программистам бд более близка реализация через B-дерево с фактором = 4.


В таком дереве каждый узел может содержать от 1 до 3 значений и от 2 до 4 указателей на потомков.

Если страница В-дерева содержит только одно значение, данный узел чёрный и имеет двух потомков.
Если страница содержит три значения, то центральный узел является чёрным, а каждый его сосед — красным.
Однако, если страница содержит два значения, любой узел может стать чёрным в красно-чёрном дереве (и тогда второй будет красным).

Пример реализации красно-черного дерева на основе B-дерева с размером блока = 3 можно посмотреть тут: BTree.scala

Для программистов БД нужно помнить 2 отличия B-дерева от B+дерева:
* при разделение элемент переносится наверх (не остается в листе)
* листы не связаны друг с другом ссылками


Красно-чёрные деревья являются одними из наиболее активно используемых на практике самобалансирующихся деревьев поиска.
В частности, контейнеры set и map в большинстве реализаций библиотеки STL языка C++, класс TreeMap языка Java, ассоциативный массив, когда реализация через списки дает слишком много коллизий
( подробное описание хэш массива тут: 3ий вариант реализации Oracle HashMap )

Популярность красно-чёрных деревьев связана с тем, что на них часто достигается подходящий баланс между степенью сбалансированности и сложностью поддержки сбалансированности при удалении.

пятница, 17 февраля 2017 г.

Oracle: Hash агрегация и приблизительный DISTINCT

Список статей о внутреннем устройстве Oracle:
Нововведение Oracle 12.1 - приблизительный подсчет уникальных значений ( APPROX_COUNT_DISTINCT ~= count distinct ).
Классический подход к расчету числа уникальных значений предполагает создание хэш массива, где ключ = колонке таблицы, а в значении число совпадений.
Число элемнтов в хэш массиве будет равно числу уникальных данных в колонке таблицы:
class RealDist {
 HashMap words;

 public RealDist() {
  words = new HashMap();
 }

 public void set(String word) {
  if (!words.containsKey(word)) {
   words.put(word, 1);
  } else {
   words.put(word, words.get(word) + 1);
  }
 } //set

 public int get() {
  return words.size();
 } //get
} // RealDist

Этот способ всем хорош, пока у нас достаточно памяти под хранение хэш массива.
При росте размера данных время и потребляемые ресурсы начинают катастрофически расти.

Пример со страницы antognini с разным числом уникальных значений на 10 млн. строк:
CREATE TABLE t
AS
WITH
  t1000 AS (SELECT /*+ materialize */ rownum AS n
   FROM dual
   CONNECT BY level <= 1E3)
SELECT rownum AS id,
    mod(rownum,2) AS n_2,
    mod(rownum,4) AS n_4,
   mod(rownum,8) AS n_8,
   mod(rownum,16) AS n_16,
   mod(rownum,32) AS n_32,
   mod(rownum,64) AS n_64,
   mod(rownum,128) AS n_128,
   mod(rownum,256) AS n_256,
   mod(rownum,512) AS n_512,
   mod(rownum,1024) AS n_1024,
   mod(rownum,2048) AS n_2048,
   mod(rownum,4096) AS n_4096,
   mod(rownum,8192) AS n_8192,
   mod(rownum,16384) AS n_16384,
   mod(rownum,32768) AS n_32768,
   mod(rownum,65536) AS n_65536,
   mod(rownum,131072) AS n_131072,
   mod(rownum,262144) AS n_262144,
   mod(rownum,524288) AS n_524288,
   mod(rownum,1048576) AS n_1048576,
   mod(rownum,2097152) AS n_2097152,
   mod(rownum,4194304) AS n_4194304,
   mod(rownum,8388608) AS n_8388608,
   mod(rownum,16777216) AS n_16777216
FROM t1000, t1000, t1000
WHERE rownum <= 1E8;
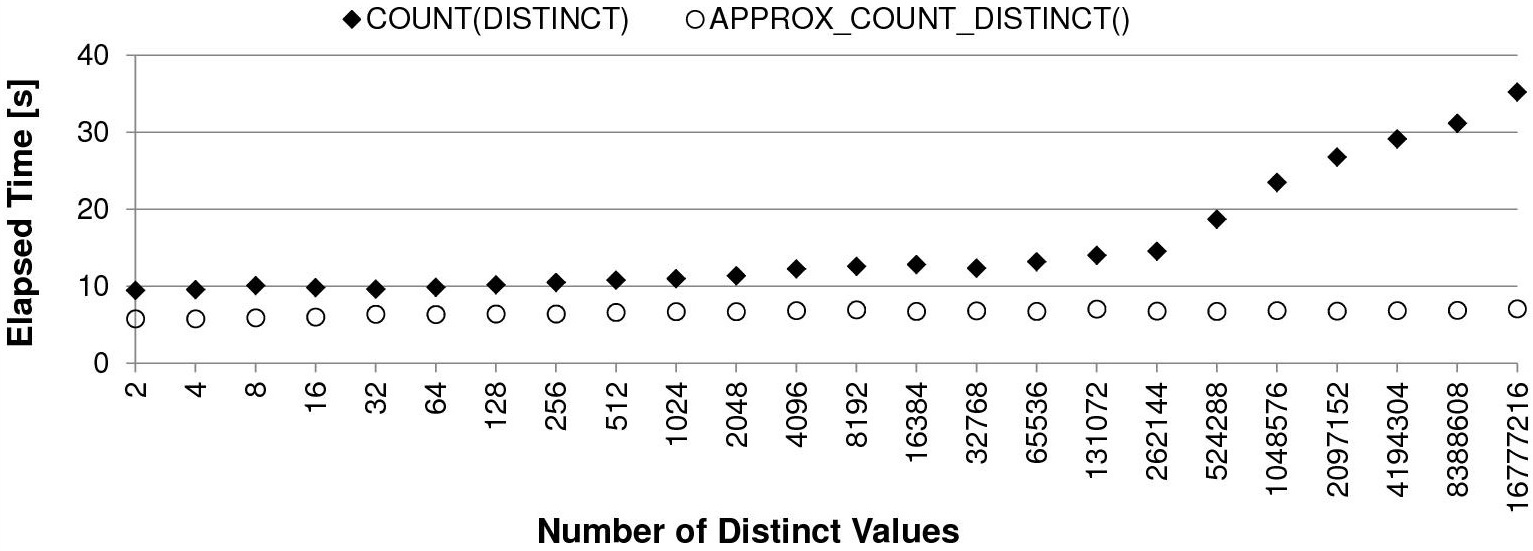
Скорость вычислений классическим способом падает вместе с ростом числа уникальных значений:


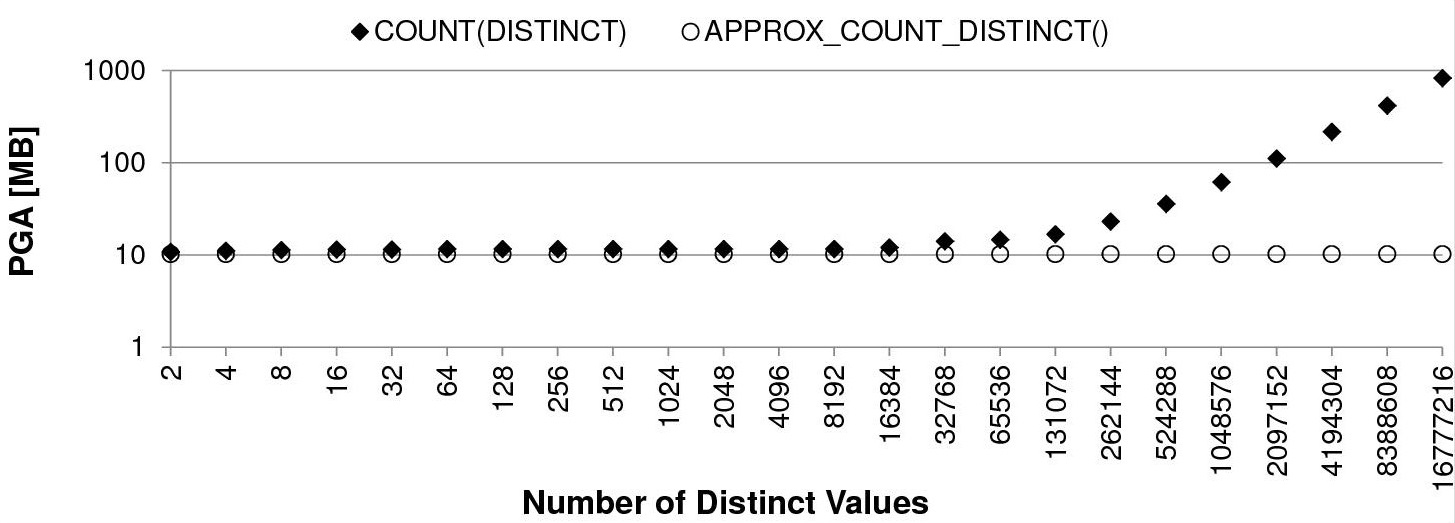
Пропорционально времени работы растет и потребление PGA памяти под хранение хэш массива:


Чтобы решить проблему производительности/памяти и при этом получить приемлемый результат, можно применить приблизительный расчет числа уникальных значений.
Как и bloom filter он основан на вероятностных хэш значениях от данных.

Общий смысл приблизительного расчета (habr):

1. От каждого значения берется произвольная хэш функция
public static int fnv1a(String text) {
 int hash = 0x811c9dc5;
 for (int i = 0; i < text.length(); ++i) {
  hash ^= (text.charAt(i) & 0xff);
  hash *= 16777619;
 }
 return hash >>> 0;
} //fnv1a

2. У каждого хэш значения определяется ранк первого ненулевого бита справа.
// позиция первого ненулевого бита справа
public static int rank(int hash, int max_rank) {
 int r = 1;
 while ((hash & 1) == 0 && r <= max_rank) {
  r++;
  // смещаем вправо, пока не дойдет до hash & 1 == 1
  hash >>>= 1;
 }
 return r;
} //rank

Вероятность того, что мы встретим хеш с рангом 1 равна 0.5, с рангом 2 — 0.25, с рангом r — 1 / 2ранг
Если запоминать наибольший обнаруженный ранг R, то 2R сгодится в качестве грубой оценки количества уникальных элементов среди уже просмотренных.

Такой подход даст нам приблизительное число уникальных значений, но с сильной ошибкой.

Для данного алгоритма есть усовершенствованный вариант HyperLogLog:

а. От битового представления хэш берется 8 первых левых бит. Они становятся ключом массива (2^8 = 256 значений)
public void set(String word) {
 int hash = fnv1a(word);
 // убираем 24 бита из 32 справа - остается 8 левых
 // (=256 разных значений)
 int k = hash >>> 24;
 
 // если коллизия, то берем наибольший ранк
 hashes[k] = Math.max(hashes[k], rank(hash, 24)); 
} // count

б. Над массивов вычисляется формула:

где am - корректирующий коэффициент, m - размер массива = 256, M[] - массив ранков (hashes)

Для погрешности в 6.5% числитель этой формулы будет равен константе = 47072.7126712022335488.
Остается в цикле возвести 2 в -степень максимального ранка из каждого элемента массива:
public double get_loglog() {
 double count = 0;

 for (int i = 0; i < hashes.length; i++) {
  count += 1 / Math.pow(2, hashes[i]);
 }

 return 47072.7126712022335488 / count;
} //get_loglog

Данный алгоритм уже дает приемлемый результат на больших данных, но серьезно ошибается на небольшом наборе.
Для небольших значение применяется дополнительная математическая корректировка:
public int get() { 
 long pow_2_32 = 4294967296L;

 double E = get_loglog();

 // коррекция
 if (E <= 640) {
  int V = 0;
  for (int i = 0; i < 256; i++) {
   if (hashes[i] == 0) {
    V++;
   }
  }
  if (V > 0) {
   E = 256 * Math.log((256 / (double) V));
  }

 } else if (E > 1 / 30 * pow_2_32) {
  E = -pow_2_32 * Math.log(1 - E / pow_2_32);
 }
 // конец коррекции

 return (int) Math.round(E);
} //get

Проведенных тест на 1-2 томах войны и мира показал результаты:
* реальное количество уникальных слов = 3737
* приблизительное число уникальных слов основываясь только на максимальном ранке первого ненулевого бита справа = 16384
* приблизительное число уникальных слов по формуле из п. б на массиве из 256 элементов = 3676
* приблизительное число уникальных слов по формуле и корректировке = 3676

При ошибке числа уникальных значений в 6,1% мы затратили константное число памяти под массив из 256 элементов, что в разы меньше, чем при обычном хэш массиве.

Полный исходный код на java можно посмотреть на github

вторник, 27 декабря 2016 г.

Oracle: Lru буферный кэш

Список статей о внутреннем устройстве Oracle:

Следующий аспект больших бд, у которых все данные не способны поместиться в памяти - кеширование частоиспользуемых данных в памяти.

В Oracle для кэширования используется модифицированный алгоритм LRU.

Lru (least recent used) кэш — буфер в памяти для быстрого доступа к часто используемым элементам.
Lru кэш представляет из себя двусвязный список (2Linked List), вначале которого наиболее часто используемые элементы, а в конце - редко.
Для ускорения произвольного доступа над списком создается хэш массив (Hash Map) ссылок на элементы двусвязанного списка:

Раньше я уже описывал lru кэш со стороны разработчика бд: Ядро oracle, сегодня копнем немного глубже, с кодом lru кэша на java.


Двусвязный список с дополнительным счетчиком обращений для хранения LRU:
//двухсвязный список
class Node<Value> {
 //ключ списка
 int key;
 
 //абстрактное значение
 Value value;
 
 //счетчик обращений к элементу
 int cnt;
 
 //указатель на предыдущий элемент
 Node prev;
 
 //указатель на следующий элемент
 Node next;
 
 //элемент был перемещен из конца списка в начало
 boolean swaped;
 
 public Node(int key, Value value){
  this.key = key;
  this.value = value;
  this.cnt = 1;
  this.swaped = false;
 }

При обращении к элементу списка увеличиваем счетчик обращений "cnt":
 //получить значение из списка
 public Value getValue() {
  //увеличиваем счетчик обращений
  cnt++;
  //сбрасываем признак смещений, если элемент был прочитан
  this.swaped = false;
  
  return value;
 }
 
 //установить значение
 public void setValue(Value val) {
  this.value = val;
  //также увеличиваем счетчик
  cnt++;
  //сбрасываем признак смещений, если элемент был перезаписан
  this.swaped = false;
 } //setValue
} //Node

Класс Lru дополняется хэш массивом "map" в котором для ускорения доступа количество хэш секций (capacity) >= числу элемнтов в списке;
И стандартные указатель на начало "head" и конец "end" списка.
Дополнительное изменение в Oracle - указатель на середину списка "cold", где начинаются холодные данные.
public class Lru<Value> {
 
 //доступной число элементов в кэше
 int capacity;
 
 //хэш массив элементов для быстрого доступа
 HashMap<Integer, Node> map;
 
 //указатель на начало (горячие элементы)
 Node head = null;
 
 //указатель на середину (начало холодных элементов)
 Node cold = null;
 
 //указатель на конец (самый редкоиспользуемый)
 Node end = null;
 
 //число элементов в кэше
 int cnt;
 
 
 //конкструктор с числом элементов в кэше
 public Lru (int capacity) {
  this.capacity = capacity;
  
  //хэш массив создаем с нужным числом секций = загруженности
  map = new HashMap<Integer, Node>(capacity);
 }

Для получения элемента используется хэш массив, без последовательного просмотра всего списка:
 //получить элемент из кэша
 public Value get(int key) {
  //быстрое извлечение их хэш массива
  if(map.containsKey(key)) {
   //и инкремент счетчика обращений
   return (Value) map.get(key).getValue();
  }
  
  return null;
 } //get

Если элементов в списке меньше размер буфера, то используется обычный алгоритм LRU - новые элементы добавляются в начало списка, а старые вытесняются вправо, пока не дойдут до конца списка.
 //места достаточно, добавляем вначало
 protected void addHead(Node n) {
  
  //первый элемент
  if(this.head == null) {
   //устанавливаем начало и конец = элементу
   this.head = n;
   this.end = n;
  } else {
   
   //вставляем вначало
   
   //следующий для нового элемента = начало списка
   n.next = this.head;
   
   //предыдущий для начала списка = новый элемент
   this.head.prev = n;     
   this.head = n;
   
   //второй элемент
   if(this.end.prev == null) {
    //предыдущий для конца = новый элемент
    this.end.prev = n;
   }
  }    
  
  //устанавливаем середину
  if(cnt == capacity / 2) {
   this.cold = n;
  }
  
  //счетчик элементов + 1
  cnt++;
 } //addHead

У этого подхода есть существенный минус: редкоиспользуемый элемент может случайно вытеснить из списка популярный блок, который не вызывался небольшой период времени, за который он успел сместиться до конца.
Для решения этой проблемы Oracle применяет 2 подхода:
1. Если в конце элемент со счетчиком обращений = 1, то он открепляется от списка, а новый блок помещается в среднюю точку cold.
Для этого ссылки соседей открепляются друг от друга и перенацеливаются на новый блок, который становится новой серединой.
 //удаляем конца списка
 private void delEnd() {
  //из хэш массива
  map.remove(this.end.key);
  
  //и делаем концом списка = предыдущий элемент
  this.end = this.end.prev;
  this.end.next = null;
 } //delEnd
 
 //вконце малопопулярный блок
 protected void addColdUnPop(Node n) {
  //удаляем конец
  delEnd();
  
  //у старой середины изменяем счетчик на 1
  if(this.cold.swaped) {
   //если смещенный элемент не был ни разу считан 
   //и дошел до середины, 
   //то сбрасываем счетчик в 1
   this.cold.cnt = 1;
   this.cold.swaped = false;
  }
  
  //новый блок в середину = cold
  
  //проставляем ссылки у нового элемента
  n.prev = this.cold.prev;
  n.next = this.cold;
  
  //и разрываем связи и соседей
  n.prev.next = n;
  n.next.prev = n;
  this.cold = n;
 } //addColdUnPop

2. Если в конце популярный элемент со счетчиком > 1 , тогда последний блок открепляется, счетчик обращений делится на 2 и этот блок перемещается в начало списка.
Такой элемент помечается флагом swaped = true, который сбрасывается при любом последующем обращении к элементу.
Это предотвращает случайное вытеснение популярного блока из памяти.
Середина списка также смещается влево, одновременно делая число обращений = 1 у новой элемента-середины, если к ней никто не обращался за время смещения от начала до середины (swaped = true).
Новый блок помещается в центр списка cold.
 //вконце популярный блок
 protected void addColdPop(int key, Value value) {
  //делим счетчик на пополам
  this.end.cnt = this.end.cnt / 2;  
  
  //открепляем конец
  Node n = this.end;
  
  //удаляем конец
  delEnd();
  
  //конец перемещаем в начало
  n.prev = null;
  n.next = this.head;
  this.head.prev = n;     
  this.head = n;
  
  //помечаем, что элемент был перемещен из конца в начало
  this.head.swaped = true;
  
  //смещаем середину на 1 влево
  if(this.cold.swaped) {
   //если смещенный элемент не был ни разу считан 
   //и дошел до середины, 
   //то сбрасываем счетчик в 1
   this.cold.cnt = 1;
   this.cold.swaped = false;
  }
  this.cold = this.cold.prev;
  
  //рекурсивно пытаемся вставить вконец
  //TODO: если все популярные? то вставка будет идти очень долго
  this.set(key, value);
 } //addColdPop


События ожиданий связанные с наполнением буферного кэша:
* Buffer busy waits / read by other session - сессия пытается считать блок, который сейчас читается в кэш или модифицируется в кэше другой сессией.

Полный исходный код можно посмотреть тут: https://github.com/pihel/java/blob/master/cache/lru.java

среда, 14 декабря 2016 г.

Oracle: вероятностный Bloom filter

Список статей о внутреннем устройстве Oracle:

Более редкая разновидность хэширования данных и вероятностной фильтрации данных - bloom filter
Раньше я уже описывал bloom filter в параллельных запросах со стороны разработчика бд: Oracle: оптимизация параллельных запросов, сегодня копнем немного глубже, с кодом bloom filter на java.


Bloom filter — это вероятностная структура данных, позволяющая компактно хранить множество элементов и проверять принадлежность заданного элемента к множеству. При этом существует возможность получить ложноположительное срабатывание (элемента в множестве нет, но структура данных сообщает, что он есть), но не ложноотрицательное.
Фильтр Блума может использовать любой объём памяти, заранее заданный пользователем, причём чем он больше, тем меньше вероятность ложного срабатывания.

Пример фильтра Блума с 18 бит в карте и 3 функциям хэширования, хранящего множество {x, y, z}. Цветные стрелки указывают на места в битовом массиве, соответствующие каждому элементу множества. Этот фильтр Блума определит, что элемент w не входит в множество, так как один из соответствующих ему битов равен нулю.

Основное предназначение - предфильтрация данных в источнике до передачи их в базу данных.
Принцип применения блум фильтра при join:
1. Левая таблица читается с диска и фильтруется (plan line = 3)
2. На основе левой таблицы создается битовая карта блум фильтра (:BF0000 plan line = 2)
3. Блум фильтр передается в источник правой таблицы (:BF0000 plan line = 4)
4. Строки правой таблицы фильтруются через блум фильтр (:BF0000 plan line = 5 - storage(SYS_OP_BLOOM_FILTER(:BF0000,"R"."L_ID")))
5. В бд передается уже частично отфильтрованная правая таблица
6. Выполняется join (plan line = 1)
create table l as select level as id, 'name_' || level as title, rpad('*', level) as pad from dual connect by level <= 50;
create table r as select rownum as id, mod(rownum, 50) as l_id, rpad('*', 20) as pad 
from (select * from dual connect by level <= 1000 ) join (select * from dual connect by level <= 1000 ) on 1=1;

begin
DBMS_STATS.GATHER_TABLE_STATS(USER, 'L');
DBMS_STATS.GATHER_TABLE_STATS(USER, 'R');
end;

explain plan for
select * 
from l
join r on l.id = r.l_id
WHERE l.title = 'name_5';

select * from table(dbms_xplan.display(format=>'ALLSTATS ALL ADVANCED'));

Plan hash value: 3967001914
 
----------------------------------------------------------------------------------------
| Id  | Operation                   | Name    | E-Rows |E-Bytes| Cost (%CPU)| E-Time   |
----------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT            |         |  20000 |  1308K|   184  (20)| 00:00:01 |
|*  1 |  HASH JOIN                  |         |  20000 |  1308K|   184  (20)| 00:00:01 |
|   2 |   JOIN FILTER CREATE        | :BF0000 |      1 |    38 |     2   (0)| 00:00:01 |
|*  3 |    TABLE ACCESS STORAGE FULL| L       |      1 |    38 |     2   (0)| 00:00:01 |
|   4 |   JOIN FILTER USE           | :BF0000 |   1000K|    27M|   171  (15)| 00:00:01 |
|*  5 |    TABLE ACCESS STORAGE FULL| R       |   1000K|    27M|   171  (15)| 00:00:01 |
----------------------------------------------------------------------------------------
 
Query Block Name / Object Alias (identified by operation id):
-------------------------------------------------------------
 
   1 - SEL$58A6D7F6
   3 - SEL$58A6D7F6 / L@SEL$1
   5 - SEL$58A6D7F6 / R@SEL$1
 
Predicate Information (identified by operation id):
---------------------------------------------------
 
   1 - access("L"."ID"="R"."L_ID")
   3 - storage("L"."TITLE"='name_5')
       filter("L"."TITLE"='name_5')
   5 - storage(SYS_OP_BLOOM_FILTER(:BF0000,"R"."L_ID"))
       filter(SYS_OP_BLOOM_FILTER(:BF0000,"R"."L_ID"))

Детальное описание с кодом на java:
1. Блум фильтр состоит из массива бит произвольной длинны. В моем случае под битовый массив выделена переменная long в 64 бита:
package Hash;

import java.util.concurrent.ThreadLocalRandom;

public class BloomFilter {

  //long переменная в 64бита под битовый массив
  private long data;
  
  //битов в битовой карте = числу битов в long
  private int bit_array_size = Long.SIZE;

2. Определяется hash_num функций хэширования. На входе функции произвольная строка, на выходе номер бита в битовой карте для установки в 1.
  //примесь для случайного хэширования
  private int seed = ThreadLocalRandom.current().nextInt(1, bit_array_size);
  
  //хэшировани = номер бита в битовом массиве
  public long hashCode(String s, int hash_num) {
    long result = 1;
    
    //для каждого байта в строке
    for (int i = 0; i < s.length(); ++i) {
      //применяем хэш функцию под номером hash_num и обрезаем по маске
     
     //простая хэш функция = ascii значение буквы * примесь * номер функции * хэш от предыдущей функции & обрезка по маске
      //1 = (1 * 1 + 58)
      //1 = ( 0001 * 0001 + 11 0001 ) & 1111 1111 1111 1111 
      result = ((hash_num + seed) * result + s.charAt(i)) & this.hashMask;
    }

3. Устанавливаем биты в битовой карте для hash_nums хэш функций
  //установить index бит в битовой карте
  public void setBit(long index) {
   //= битовая карта OR 1 смещенное влево на index
   this.data = this.data | (1L << index );
  } //setbit
  
  //добавить элемент в блум фильтр
  public void add(String s) {
    //++ счетчик элементов
    cnt++;
    //для каждой хэш функции
    for(int i = 1; i <= hash_nums; i++) {
      //расчитаем номер индекса в битовой карте и установим его
      long index = hashCode(s, i);
      setBit(index);
    }
  } //add

4. Обратная операция - тестирование строки на вероятное наличие элемента в блум фильтре: хэшируем и проверяем бит в блум фильтре
  //получить значение бита на index месте
  public long getBit(long index) {
   //=битовая карта смещенная вправо на index мест (>>> пустые места справа заполняются 0)
   // & 01 - проверка только крайнего правого бита (все остальные игнорируются)
   return ( this.data >>> index ) & 1;
  } //getBit
  
  //проверка наличия элемента в блум фильтре
  public boolean test(String s) {
 //для каждой хэш функции
    for(int i = 1; i <= hash_nums; i++) {
      //определяем номер бита в битовой карте
      long index = hashCode(s, i);
      
      //если хотябы одна проверка не прошла - элемента нет
      if( getBit(index) == 0L ) return false;
    }
    
    //иначе элемент вероятно есть
    return true;
  } //test

Очевидно, чем больше битовая карта в блум фильтре, тем точней результат - меньше ложных срабатываний.
Зависимость определяется формулой:

, где n — предполагаемое количество элементов хранящихся в фильтре-множестве, p — вероятность ложного срабатывания, m - число бит в карте

  //вероятность ложного срабатывания
  public double getFalsePossb() {
   if(cnt == 0) return 0;
   return 1 / Math.pow(Math.E, bit_array_size * Math.log(2) * Math.log(2) / cnt );
  } //getFalsePossb

Вероятность ложного срабатывания от числа бит в карте и кол-ва элементов:


Также использование нескольких функции хэширования дает преимущество при достаточном размере блум фильтра:
  //оптимальное число функций хэширования
  public int getOptimalFncCnt() {
   if(cnt == 0) return 1;
   return (int)Math.ceil( bit_array_size / cnt * Math.log(2) );
  } //getOptimalFncCnt

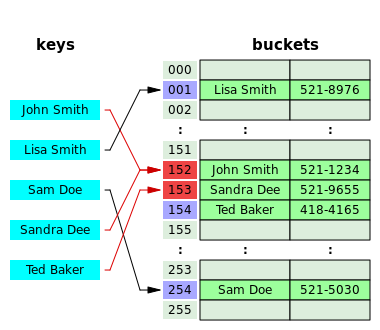
График вероятности ложного срабатывания от размера массива и числа функций хэширования:

Практическое применение Bloom фильтра в Oracle:
* Partition pruning - усечение просматриваемых партиций
 На основе фильтра левой таблицы выбираются секции для сканирования из правой, что позволит не сканировать таблицу целиком.
* RAC - уменьшение сетевого трафика между кластерными нодами
 Для уменьшения сетевого взаимодействия между кластерными нодами, если левую таблицу читает 1 нода, а правую нода 2.
 Применение блум фильтра уменьшает размер пересылаемых данных правой таблицы из ноды 2 в ноду 1 до выполнения соединения.
* Exadata или Map reduce движок в качестве источника данных
 Массовая параллельная обработка внутри exadata проходит быстрей, чем аналогичная операция внутри бд Oracle.
 Из-за этого при наличии exadata Oracle стремится произвести максимальное число фильтрации в источнике до передачи в базу.
* In Memory хранилище данных
 Аналогично exadata, inmemory движок может производить фильтрацию внутри себя и это будет быстрей, чем выполнять join на полном наборе данных.
 При наличии таких данных Oracle стремится произвести максимум фильтрации до передачи данных в бд.
* Parallel - параллельные запросы
 Взаимодействие параллеьлных поток происходит через координатор и если 1 поток читает левую таблицу, а 2 поток - правую, то выгодней и быстрей отфильтровать правую таблицу блум фильтром и передать в первый поток уже отфильтрованные данные.
* Гетерогенные запросы через дблинк (возможно)
 Сетевое взаимодействие очень дорогое по сравнению с работой с памятью и даже диском. Из-за этого было бы выгодно отфильтровать правую таблицу на удаленной бд до ее передачи в нашу.

Полную реализацию блум фильтра можно видеть здесь: https://github.com/pihel/java/blob/master/Hash/BloomFilter.java

суббота, 3 декабря 2016 г.

Oracle: реализация hash соединения

Список статей о внутреннем устройстве Oracle:

Следующий аспект бд - хэширование данных
Раньше я уже описывал hash join со стороны разработчика бд: Основы стоимостной оптимизации join, сегодня копнем немного глубже, с кодом hash join на java.


Хэширование - преобразование массива входных данных произвольной длины в выходную битовую строку фиксированной длины, выполняемое определённым алгоритмом.
Преимуществом массива фиксированной длины является константное время доступа к его элементам из-за размещения ограниченного набора в процессорном кэше.
Самая большая проблема - это выбор хэширующей функции, которая давала бы минимум коллизий (одинаковых значений хэш функции для разных ключей массива).
Идеальная хэширующая функция не должна давать коллизий, но в реальности такую функцию сложно получить.
В моем случае алгоритмом хэширование я выбрал остаток от деления. Число в знаменателе даст нам такое же число элементов в хэш массиве.
Для разрешения проблемы коллизий используется 2 подхода, оба из них в зависимости от числа коллизий для доступа к нужному элементу дают от 1 до N обращений:

1. Открытая адресация
Коллизии размещаются в томже хэш массиве, но смещаются вправо, пока не найдется свободное место.

Пример:
Массив из элементов: 1, 11, 2, 3
Хэширующая функция: остаток от деления на 10
Результирующий хэш массив:
[1] = 1 (остаток от деления 1 на 10 = 1, т.к. ключ 1 был пустой, то он и занимается)
[2] = 11 (остаток от деления 11 на 10 = 1, это коллизия для предыдущего элемента. Т.к. ключ 1 занят, то берется следующий пустой справа = 2)
[3] = 2 (остаток от деления = 2, т.к. элемент занят, то берется следующий = 3)
[4] = 3 (и т.д.)

Реализацию на java можно посмотреть здесь.

2. Метод цепочек
Хэш таблица содержит список коллизий. Число элементов хэш таблицы фиксировано = числу различных вариантов хэширующей функции.
Пример на том же массиве и той же хэширующей функции:
[1] = 1 -> 11
[2] = 2
[3] = 3
[4] = 4

3. Метод красно-черного дерева
В случае большого числа коллизий, когда все элементы попадают в одну хэш секцию, для хранения данных секции целесообразно использовать красно-черное дерево, замен списка во 2 методе. В этом случае поиск элемента будет осуществляться за логарифмическое время, вместо линейного в списке.

Плюсы и минусы подходов:
Сравниваемое свойство Цепочки Открытая адресация
Разрешение коллизий Используются дополнительные списки Хранится в самом хэш массиве
Использование памяти Дополнительная память для указателей в списке.
В случае неудачной хэш функции, если все элементы легли в один элемент массива (хэш секцию), то размер памяти будет почти в 2 раза больше, т.к. необходимая память под указатели будет равна памяти под ключи.
Нет доп. расходов
Зависимость производительности от заполненности таблицы Прямо пропорционально значению = число элементов / кол-во хэш секции таблицы число элементов / ( кол-во хэш секции таблицы - число элементов )
Возможность записи числа элементов больше размера хэш таблицы Да, за счет записи коллизий в список Нет, т.к. колллизии храняться в томже массиве
Простота удаления Да, удаляется элемент из списка Нет, пустое место нужно помечать удаленным, а не очищать физически. Т.к. при вставке ищутся пусты места справа, что может сломать последовательность
Использование кэша процессора Нет (переходы по ссылке) Да (Все данные рядом)

Детали реализации Oracle:
Хэширование цепочками наиболее понятное, но оно же дает худшую производительность, т.к. не использует кэш процессора из-за постоянных переходов по ссылке.
По этому все нагруженные реализации используют Hash таблицы с открытой адресацией, где все данные лежат рядом и используют кэш сопроцессора.


Слева графически представлен механизм поиска в хэш таблице Oracle.

Изменения в реализации хэш таблиц Oracle:
* Хэш таблица над таблицей бд может быть сколь угодно большой и она может не поместиться в памяти
* битовая карта над данными в хэш таблице, если соответствующий бит таблицы установлен, то элемент есть в хэш таблице, иначе строку можно даже не искать.


Когда Oracle выбирает соединение хэшированием:
В основе выбора способ лежит стоимостная оценка:
Стоимость соединения вложенными циклами (NL) = стоимость получения T1 + кардинальность Т1 * Стоимость одного обращения к Т2
Стоимость соединения хэшированием (hash) = стоимость получения Т1 + стоимость получения Т2 + стоимость хэширования и сравнения.

Исходя из этих формул можно сделать вывод, что hash соединение выгодней, когда :
* Нужно считать большой объем данных для соединения или на правой таблице таблице нет индекса.
Многоблочное считывание при hash join выгодней, чем последовательное одноблочное сканирование индекса правой таблицы.
* Параллельное выполнение запросов - хэширование и поиск в хэш таблице хорошо распараллеливается, поиск по связанному списку индекса практически не параллелится.

Когда hash join не может быть использован:
* Поиск по диапазону (или любой операции отличной от = ) не применим для хэш таблицы, результат функции дает непоследовательные данные, которые не просканировать последовательно.


Рассмотрим подробней вариант, однопроходного поиска в хэш таблице, т.е. когда объема памяти достаточно, чтобы целиком разместить хэш секцию.
Для простоты будет использоваться Hash таблица цепочками.